Datum: 17. november 2026
Čas branja: 1 min
Slovenski jezik je dosegel še en pomemben mejnik v digitalnem razvoju. Jezik z nekaj več kot dvema milijonoma govorcev je dobil svoj veliki jezikovni model, s čimer se je Slovenija pridružila skupini držav, ki umetno inteligenco razvijajo tudi v lastnem jeziku in tako krepijo svojo tehnološko suverenost.
Generativni model za slovenščino oziroma GaMS so razvili strokovnjaki Centra za jezikovne vire in tehnologije Univerze v Ljubljani. Njihov cilj je bil razviti veliki jezikovni model za slovenščino in hkrati vzpostaviti temeljno infrastrukturo za razvoj umetne inteligence v slovenskem jeziku.
Korak k tehnološki suverenosti
Čeprav se lahko v slovenščini pogovarjamo tudi z velikimi jezikovnimi modeli, kot so ChatGPT, Claude in Gemini, so ti večinoma naučeni na besedilih v angleščini ali drugih svetovnih jezikih. Zato v slovenskem jeziku pogosto delujejo slabše, saj ne prepoznajo njegovih posebnosti, kulturnega ozadja in značilnosti slovenskega prostora. Ker je bil GaMS izurjen na slovenskih besedilih, za učenje modela so uporabili približno 25 milijard besed v slovenščini, dobro razume jezikovne posebnosti. Kot je ponazoril glavni razvijalec Domen Vreš:
»Ni več ameriški John, ki poskuša govoriti slovensko, ampak precej bolj naš slovenski Janez.«
-
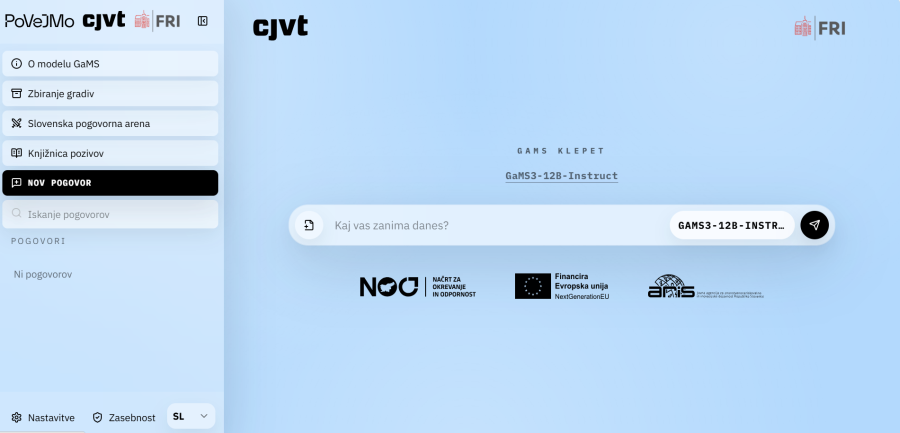
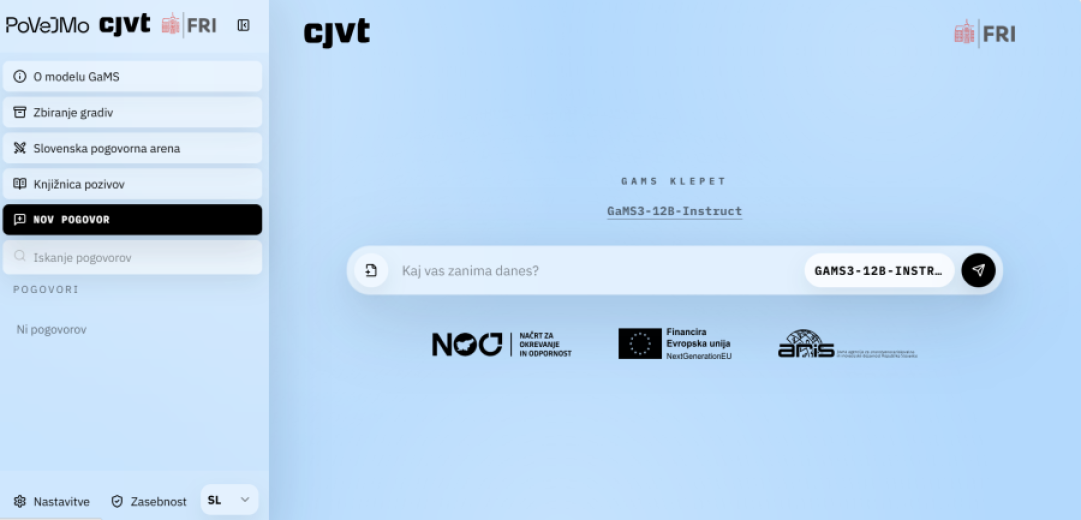 Veliki jezikovni modeli spreminjajo način komuniciranja, dostop do informacij in uporabo spleta. Foto: Zajem zaslona
Razvoj velikega jezikovnega modela za slovenščino je zahteval ogromne količine slovenskih besedil in računske moči, zato so poleg slovenskega superračunalnika Vega uporabili tudi evropski superračunalnik Leonardo v Bologni.»GaMS spada med najuspešnejše odprtodostopne velike jezikovne modele v svojem velikostnem razredu,« razloži vodja razvoja modela Marko Robnik Šikonja.
Raziskovalci napovedujejo nadaljnji razvoj modela z novimi funkcionalnostmi, ki bodo omogočale samostojnejše izvajanje nalog, ter njegovo dodatno učenje v okviru Slovenske tovarne umetne inteligence. Ob tem poudarjajo, da bosta za nadaljnji razvoj ključna dostop do kakovostnih slovenskih besedil ter ustrezno ravnovesje med varovanjem avtorskih pravic in razvojem umetne inteligence.
-
 Veliki jezikovni modeli so vrsta umetne inteligence, ki se uči jezika na velikanskih zbirkah podatkov, na ogromnih količinah besedil, kot so spletne strani, knjige, članki in drugi zapisi. Foto: ole CNX/Getty Images
Uporaba v medicini, industriji, humanistiki in informatiki
GaMS je namenjen uporabi v raziskovanju, izobraževanju, gospodarstvu in javnem sektorju.
V okviru projekta so delovanje modela že preizkusila nekatera slovenska podjetja. Better ga je uporabil za razvoj napredne medicinske aplikacije, ki omogoča elektronsko podpisovanje zdravil, samodejno pretvorbo govora za odpustna pisma ter digitalizacijo obrazcev s prepoznavanjem besedilnih polj in vnosov.
Podjetje Semantika je model prilagodilo za samodejno pripravo večjezičnih predstavitvenih gradiv in napredne interaktivne aplikacije v muzejih, Špica pa je razvila napredno industrijsko aplikacijo, ki z uporabo umetne inteligence avtomatizira in pospešuje delovne procese v proizvodnji, skladiščih in oskrbovalnih verigah. Tudi v podjetju XLAB so z uporabo modela GaMS razvili napredno aplikacijo, in sicer za večjo podatkovno učinkovitost ter večjo pravilnost in zanesljivejše delovanje pri pisanju izvorne kode in dokumentacije.
-
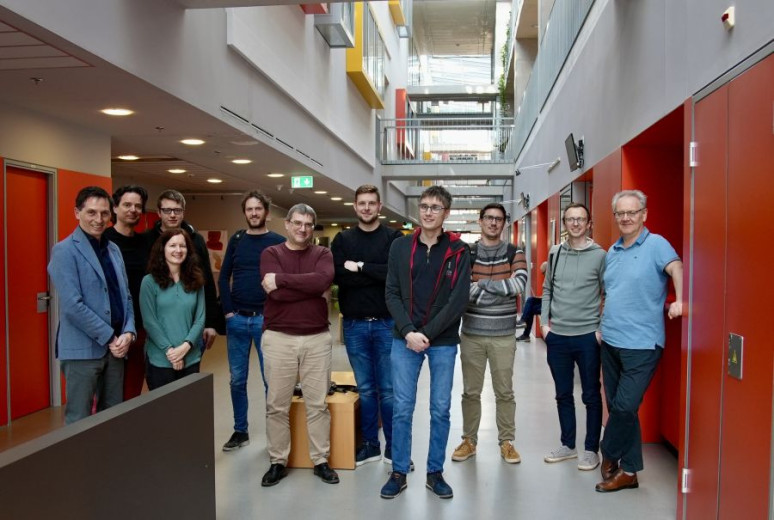 Da bi slovenščina obdržala svoj prostor v digitalni prihodnosti, so strokovnjaki s Centra za jezikovne vire in tehnologije Univerze v Ljubljani zgradili generativni model za slovenščino oziroma GaMS. Foto: PoVeJMo

Vse različice velikega generativnega jezikovnega modela za slovenščino GaMS so javno dostopne za uporabo, lokalno namestitev in prilagoditev različnim potrebam uporabnikov. GaMS tako prispeva k varnejši uporabi umetne inteligence, večji zaščiti slovenskega jezika v digitalnem prostoru in h konkurenčnosti slovenskega gospodarstva.
Naslovna fotografija: Tippapatt/Getty Images